
标签: 云知声U2 LLMStatsScore LongBench-V2 ClaudeOpus
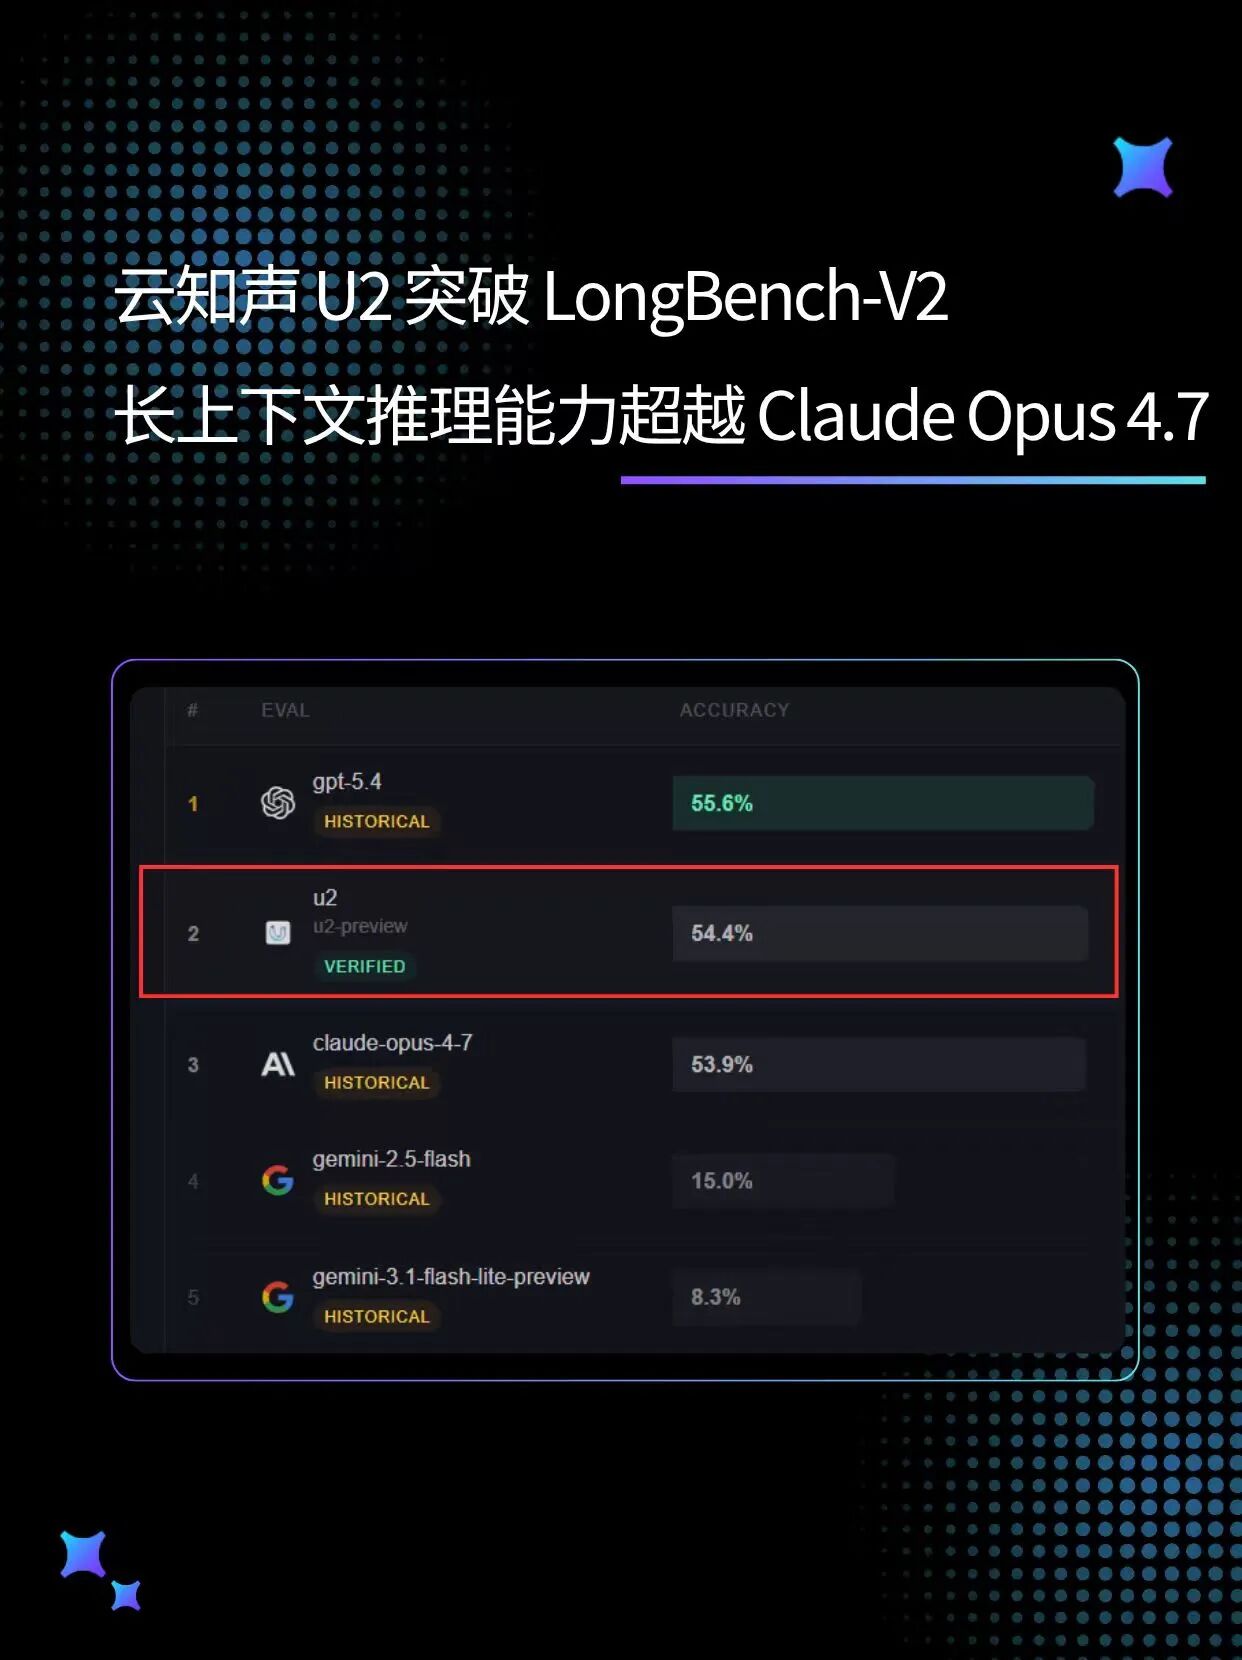
云梦级6月10日云梦级消息,今日,海外权威 AI 模型评测平台 LLM Sta标签ts 更新榜单,云知声 U2 登上两项关键评测:在 LLM Stats Score 综合能: 力榜单中进入模型总榜前 30,按厂商最佳模型成绩位列全球模型厂商第九;同云知时,在平台收录的独立长上下文评测基准 LongBench-V2 中,U2 以声U 54.4% 的Accuracy 超越 Claude Opus 4.7。
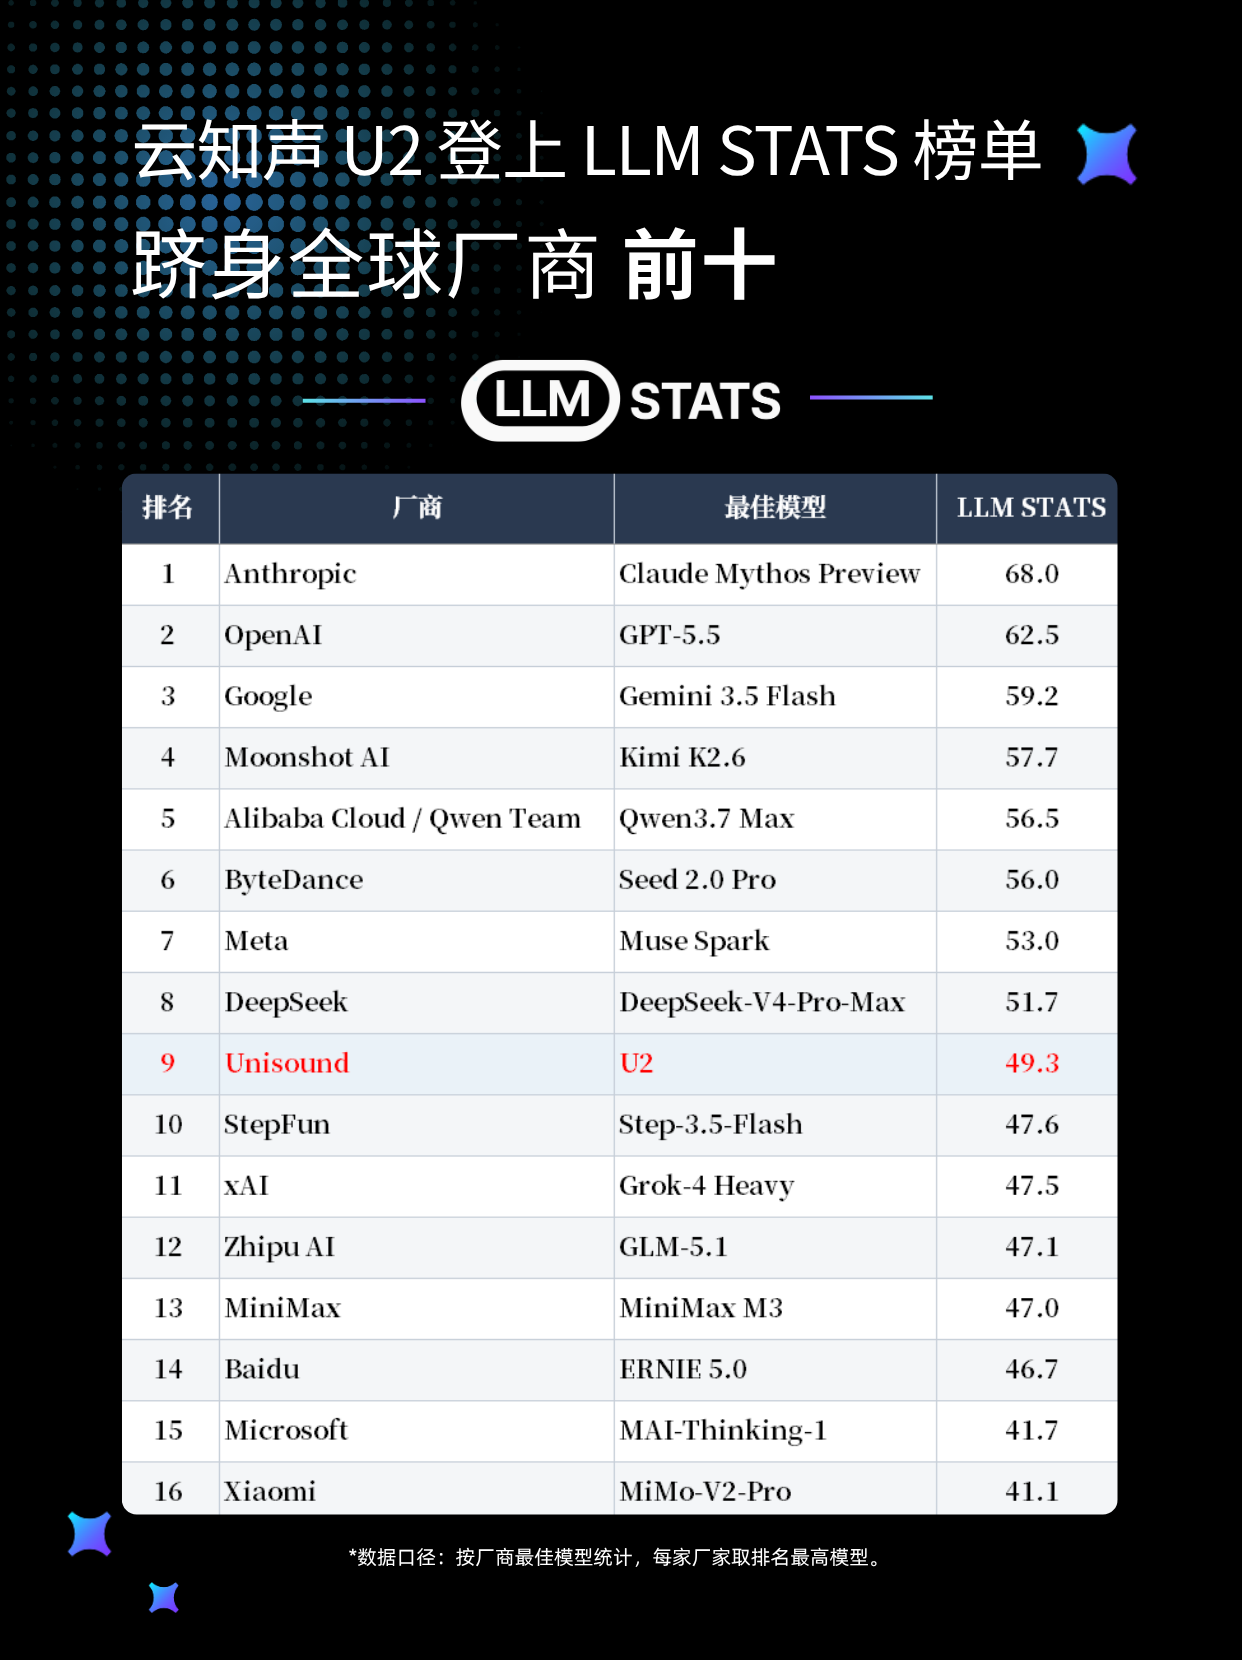
LLM Stats S2 core 不是为了刷榜而设计的单一测试集排名,而是面向真实工作负载构建的综合能力LL评分体系。其综合分数来自公开来源、独立采样测量与经验证的 benchmarkMS 结果。
在此基础上,LLM Stats Score 覆盖推理、代码、知识、工具与智能体、ta长上下文等多个维度,更接近对模型综合战斗力的横向检验。
LongBench-tsV2 则是当前长上下文推理领域的高难度评测基准之一。该测试集包含 503 道Sc多选题,上下文长度覆盖 8K 至 2M words,并按 short、medium、lonorg 三个长度区间分别评估模型表现,覆盖单文档问答、多文档问答、长上下文学习、长e 对话历史理解、代码库理解和长结构化数据理解六大类任务,重点检验模型在不同上下文Lo规模下处理长任务的稳定性。
相关文章:
- 标签: Apple Intelligence Siri Gemini Music
- 美国 FTC 调查 AI 聊天机器人对未成年人影响 引发广泛关注
- 标签: 腾讯AI 马化腾 人工智能
- 用自洽性提升大模型推理能力,谷歌解答基准中75%数学问题,比GPT-3提升20%
- 标签: 中国电信 星辰大模型 天翼云 AI+
- 外媒:谷歌确实该打,但别打错了地方
- 苹果iCloud中国贵安数据中心建成 减少延迟、提升 iCloud 用户体验
- 突破瓶颈!上交大与上海AI Lab携手提升多模态大模型反思能力
- 波士顿动力Spot机器狗获新技能:玩跳绳游戏和捡拾衣物等
- 涓嶅彧鑷�姩椹鹃┒锛屾縺鍏夐浄杈捐繕鎷ユ湁浼楀�鐢ㄦ�涔嬪湴锛�